Datenmodell
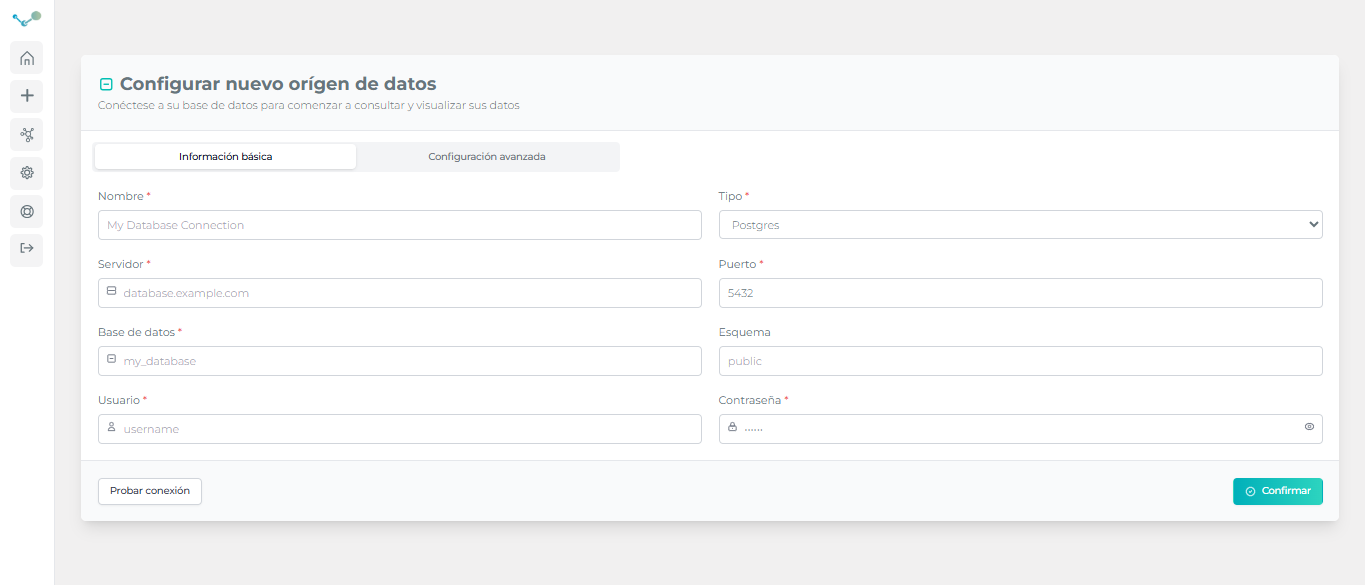
Edalitics ermöglicht die Erstellung eines logischen Datenmodells, aus dem Benutzer auf einfache und intuitive Weise Berichte erstellen können. Ein Administrator kann Datenmodelle erstellen. Um ein Datenmodell zu erstellen, muss ein Administrator eine Datenbankverbindung konfigurieren und ihr einen Namen geben:
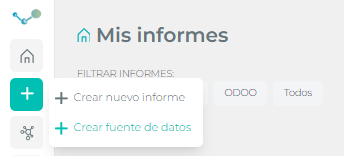
Sobald die Verbindungsdaten angegeben wurden, generiert EDA automatisch ein logisches Modell. Dabei werden generiert:
- Entitäten aus den Tabellen und Attribute aus den Spalten.
- Beziehungen zwischen den verschiedenen Tabellen anhand von Spalten mit demselben Namen und ID-Format (Felder, die id_, fk_, code oder nk_ enthalten)
- Wenn wir die Option “Abfragen optimieren” aktivieren, erhalten wir außerdem Statistiken über die Größe der Tabellen, mit denen der Benutzer bei der Erstellung von Berichten beraten wird. So werden unnötig schwere Abfragen vermieden.
Es wird ein logisches Modell erzeugt, das mit Namen und Beschreibungen angereichert ist, sodass der Fachanwender den Inhalt des Datenmodells vollständig verstehen kann.
Um ein Datenmodell zu erstellen, sind lediglich die Verbindungsdaten zur Datenbank erforderlich:
- Verbindungsname
- Verbindungstyp (MySql, PostgreSQL, Oracle, SqlServer, Snowflake, Vertica usw.)
- Server
- Name der Datenbank
- Schema (falls zutreffend)
- Benutzer
- Passwort
- Filter: Ermöglicht die Angabe der Tabellen, die in das Modell aufgenommen werden sollen, durch Verkettung der Elemente tabelle_a, tabelle_b, tabelle_c oder mithilfe von SQL-Mustern wie eda_%
Datenmodelle können angereichert werden mit:
- Ansichten auf Modellebene: Ermöglicht die Definition von Ansichten auf Ebene des logischen Modells, die sich wie neue Tabellen verhalten. Dies ist besonders empfehlenswert, wenn komplexe Abfragen wiederholt verwendet werden. Eine Ansicht kann auf Ebene des logischen Modells definiert werden. So fügen Sie eine Ansicht hinzu
- Erzeugung von Entitäten aus einer CSV-Datei: Für dynamische Umgebungen konzipiert. Eine neue Entität kann im Modell aus einer CSV-Datendatei erzeugt werden. Diese Funktion lädt die CSV-Daten in eine Datenbanktabelle. Diese Funktion ist nur bei Modellen aktiviert, die mit PostgreSQL definiert wurden. So laden Sie eine CSV-Datei hoch
- Berechnete Felder: Sie können einer Tabelle ein berechnetes Feld hinzufügen, mit dem Sie Operationen ausführen können. Wenn Sie ein numerisches Feld erzeugen möchten, müssen Sie die gewünschte Aggregation angeben. So fügen Sie ein berechnetes Feld hinzu Sie können sich auch das Video ansehen: https://youtu.be/UT9d6EOpLO0
- Karten: Geojson-Dateien können hochgeladen und mit einem (oder mehreren) Attributen verknüpft werden, sodass Layer-Karten erzeugt werden können, die mit diesen Attributen verknüpft sind.
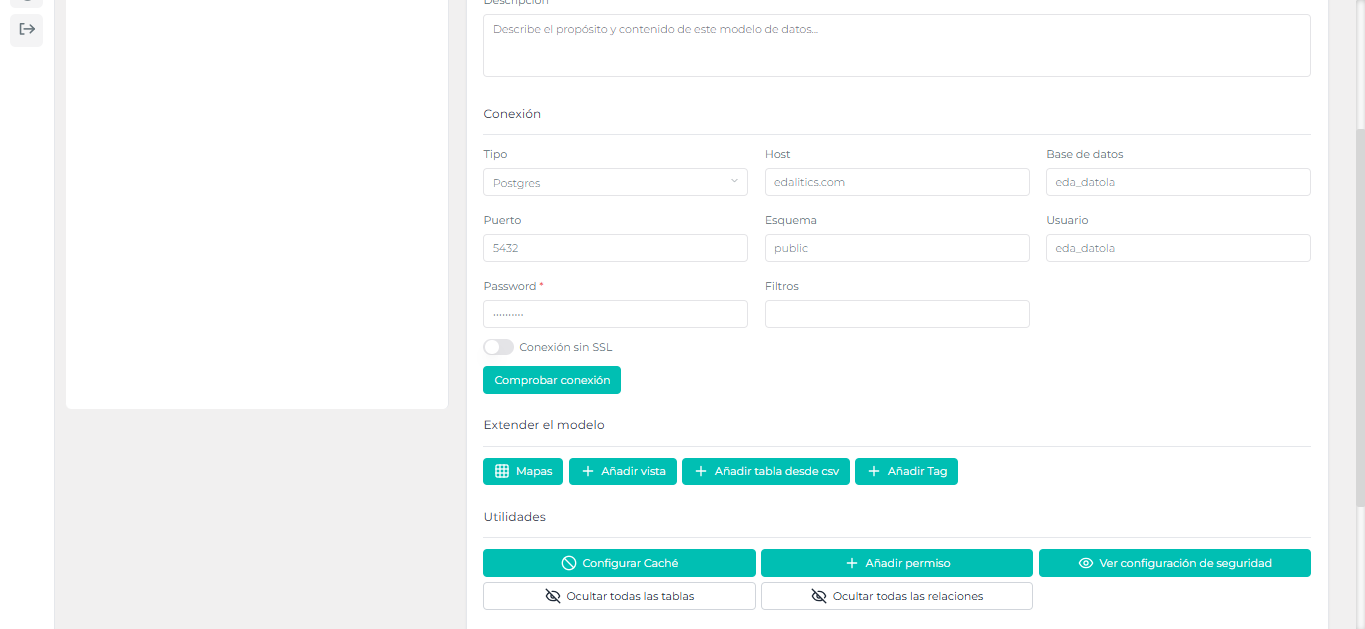
Datenmodelle können auf Datenebene abgesichert werden, wodurch Sie Sicherheit auf Datensatzebene definieren können. Die Sicherheit wird auf den Sitzungsbenutzer angewendet.
Datenmodelle bestimmen, ob Abfragen gegen dieses Modell Daten zwischenspeichern (Cache) und wie lange dieser Cache gültig ist.
Video-Tutorial
Abschnitt betitelt „Video-Tutorial“Das Modell anpassen
Abschnitt betitelt „Das Modell anpassen“edalitics generiert das Datenmodell automatisch. Dies ist jedoch nur eine Hilfestellung. Das Datenmodell kann angepasst werden, indem Sie:
- Tabellen ausblenden
- technische Spalten ausblenden, die im Modell nicht erscheinen sollen
- die Namen von Tabellen oder Spalten ändern
- aussagekräftige Beschreibungen erstellen
- Beziehungen zwischen Tabellen erstellen oder löschen
- berechnete Spalten hinzufügen So fügen Sie ein berechnetes Feld hinzu
- Listen möglicher Werte definieren
Das Datenmodell von EDA
Abschnitt betitelt „Das Datenmodell von EDA“Nachfolgend ist ein edalitics-Datenmodell dargestellt
{    "_id": "XXXX", // Model's id    "ds": {        "connection": {            "database": "mydb", //  Database name            "host": "127.0.0.1", // Database server            "password": "xxxx", // Database password            "poolLimit": 10, // In case you want to activate pool the number of concurrent connections (only with mysql)            "port": 3306,            "schema": "",            "searchPath": "",            "sid": 1,            "type": "mysql",// Database type. Possible values: 'postgres', 'mysql', 'vertica', 'sqlserver', 'oracle', 'bigquery', 'snowflake', 'jsonwebservice'            "user": "myuser",            "warehouse": "" // For Snowflake        },        "metadata": {            "cache_config": {  // Cache configuration                "enabled": false,                "hours": "06",                "minutes": "00",                "quantity": 1,                "units": "days"            },            "filter": "",            "model_granted_roles": [ // Security configuration                {                    "column": "fullModel",                    "global": true,                    "none": false,                    "permission": true,                    "table": "fullModel",                    "type": "anyoneCanSee",                    "users": [                        "(~ => All)"                    ],                    "usersName": [                        "(~ => All)"                    ]                }            ],            "model_id": "",            "model_name": "edalitics MODEL",            "optimized": false,            "external" : {}        },
        "model": {            "maps": [ ],  // Maps Configuration            "tables": [  // Tables list                {                    "table_name": "table_a", // Database's table name                    "table_type": [],                    "display_name": {                        "default": "Table A Description",   // Name of the table that the user will see                        "localized": [ ]                    },                    "description": {                        "default": "Table A description ",  // Description of the table that the user will see                        "localized": [ ]                    },
                    "tableCount": 0, // Number of records in the table. It is used for optimizations.                    "visible": true, // Determines whether the table is visible to the user or has a technical function                    "columns": [ // List of table columns                        {                            "aggregation_type": [  // Possible column aggregations                                {                                    "display_name": "Cuenta Valores",  // Name that the user will see                                    "value": "count"      // Aggregation type                                },                                {                                    "display_name": "Valores Distintos",                                    "value": "count_distinct"                                },                                {                                    "display_name": "No",                                    "value": "none"                                }                            ],                            "column_granted_roles": [ ],                            "column_name": "id", // Table column name                            "column_type": "numeric", // Column type. Possible values are numeric, text, date, coordinate                            "display_name": {                                "default": "Columna con el id", // Name of the column that the user will see                                "localized": [                                ]                            },                            "description": {                                "default": "Columna con el id de la tabla ",// Description of the column that the user will see                                "localized": [                                ]                            },                            "minimumFractionDigits": 0, // Number of decimal places the user will see on the front-end                            "row_granted_roles": [ ],                            "tableCount": 0,                            "valueListSource": {  // In case the column is an id pointing to a value list                            },                            "visible": true  // Determines whether the user sees the column (true) or whether it is hidden or hidden (false)                        }                    ],                    "no_relations": [],                    "relations": [  // Table relationships. What other tables is it related to and how?                        {                            "display_name": {                                "default": "Relation Name", // Name to display for the relationship                                "localized": [ ]                            },                            "source_column": [  // Origin column(s)                                "id"                            ],                            "source_table": "table_a", // Source table                            "target_column": [ // Destination column(s)                                "id"                            ],                            "target_table": "table_b",  // Destination table                            "visible": true  // Whether it is visible, active or not.                        }                    ]
                },
                {                    "table_name": "table_b",                    "table_type": [],                    "description": {                        "default": "Table B Name",                        "localized": [ ]                    },                    "display_name": {                        "default": "Table B Description",                        "localized": [ ]                    },                    "tableCount": 0,                    "visible": true,                    "columns": [                        {                            "aggregation_type": [                                {                                    "display_name": "Cuenta Valores",                                    "value": "count"                                },                                {                                    "display_name": "Valores Distintos",                                    "value": "count_distinct"                                },                                {                                    "display_name": "No",                                    "value": "none"                                }                            ],                            "column_granted_roles": [                            ],                            "column_name": "id",                            "column_type": "numeric",                            "description": {                                "default": "ID",                                "localized": [                                ]                            },                            "display_name": {                                "default": "ID",                                "localized": [                                ]                            },                            "hidden": 0,                            "minimumFractionDigits": 0,                            "row_granted_roles": [                            ],                            "tableCount": 0,                            "valueListSource": {                            },                            "visible": true                        }                    ],                    "no_relations": [],                    "relations": [                        {                            "bridge": false,                            "display_name": {                                "default": "Relation Name",                                "localized": [ ]                            },                            "source_column": [                                "id"                            ],                            "source_table": "table_b",                            "target_column": [                                "id"                            ],                            "target_table": "table_a",                            "visible": true                        }                    ]
                }            ]        }    }}